
技术 SEO
robots.txt 与 noindex 有什么区别?抓取与索引别混用
理解 robots.txt、noindex 元标签与 X-Robots-Tag 的用途,避免阻止抓取后爬虫读不到索引指令,并按步骤验证实际配置。
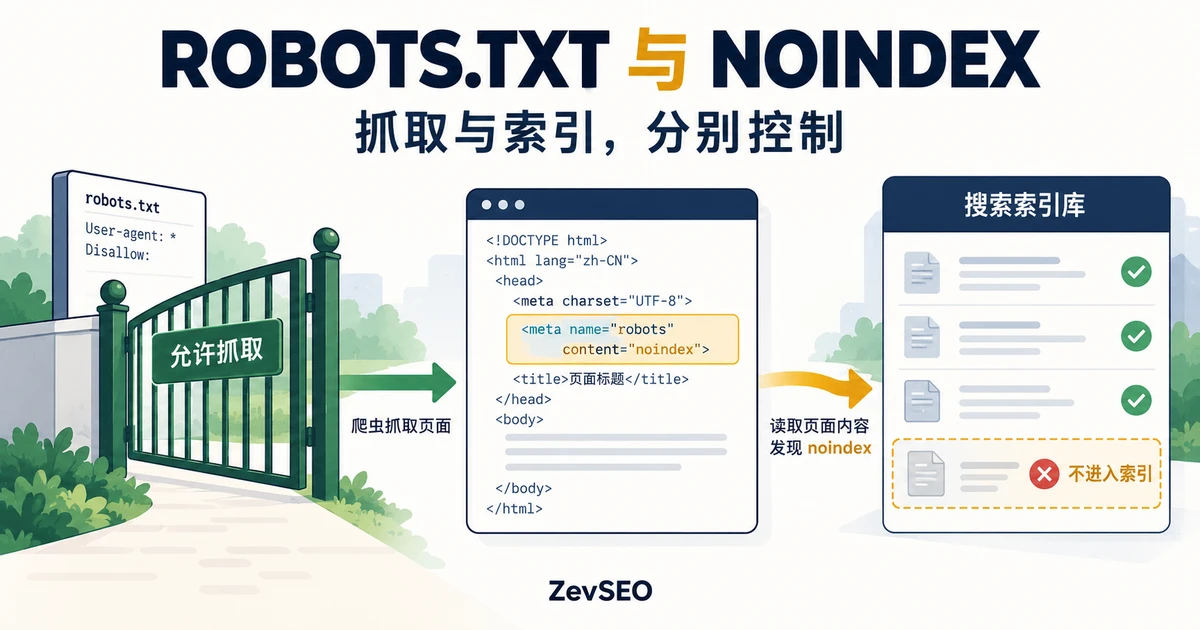
你不希望某个页面出现在 Google,于是把它写进 robots.txt。过了一段时间,搜索结果里却还能看到这个 URL。你又补上 noindex,仍然没有看到预期变化。
问题可能出在这两个配置的组合上:爬虫被阻止访问页面,也就读不到你希望它执行的指令。
robots.txt 用于管理支持这些规则的爬虫访问,noindex 用于控制可访问内容的索引,私密内容则需要身份验证和访问控制。 先明确目标,再选择对应机制。
下面用一个假设 SaaS 网站说明配置与验证方法。代码和情形都是教学示例,不是客户站点的实测记录。
一、抓取与索引,是两个不同的决定
爬虫需要先取得资源,才能读取页面上的索引指令。搜索引擎再决定如何处理资源,以及是否将其纳入索引。
Google 在 robots.txt 入门说明中指出,它用于管理爬虫访问;如果通过其他途径发现 URL,即使抓取被禁止,URL 仍可能出现在搜索结果中。
| 你的目标 | 可以采用的起点 | 不能据此认定什么 |
|---|---|---|
| 减少某些路径被抓取 | 对相应爬虫配置 robots.txt | 页面已从索引删除 |
| 公开 HTML 页面可以访问,但不进入搜索 | 页面上的 noindex 元标签 | 别人无法打开这个 URL |
| 排除可访问的 PDF 等资源 | HTTP 响应中的 X-Robots-Tag | 别人无法下载文件 |
| 保护客户内容或测试环境 | 身份验证和访问控制 | robots.txt 本身能够保护内容 |
| 让公开产品页参与搜索 | 允许访问,移除意外的索引限制 | 一定会收录或获得排名 |
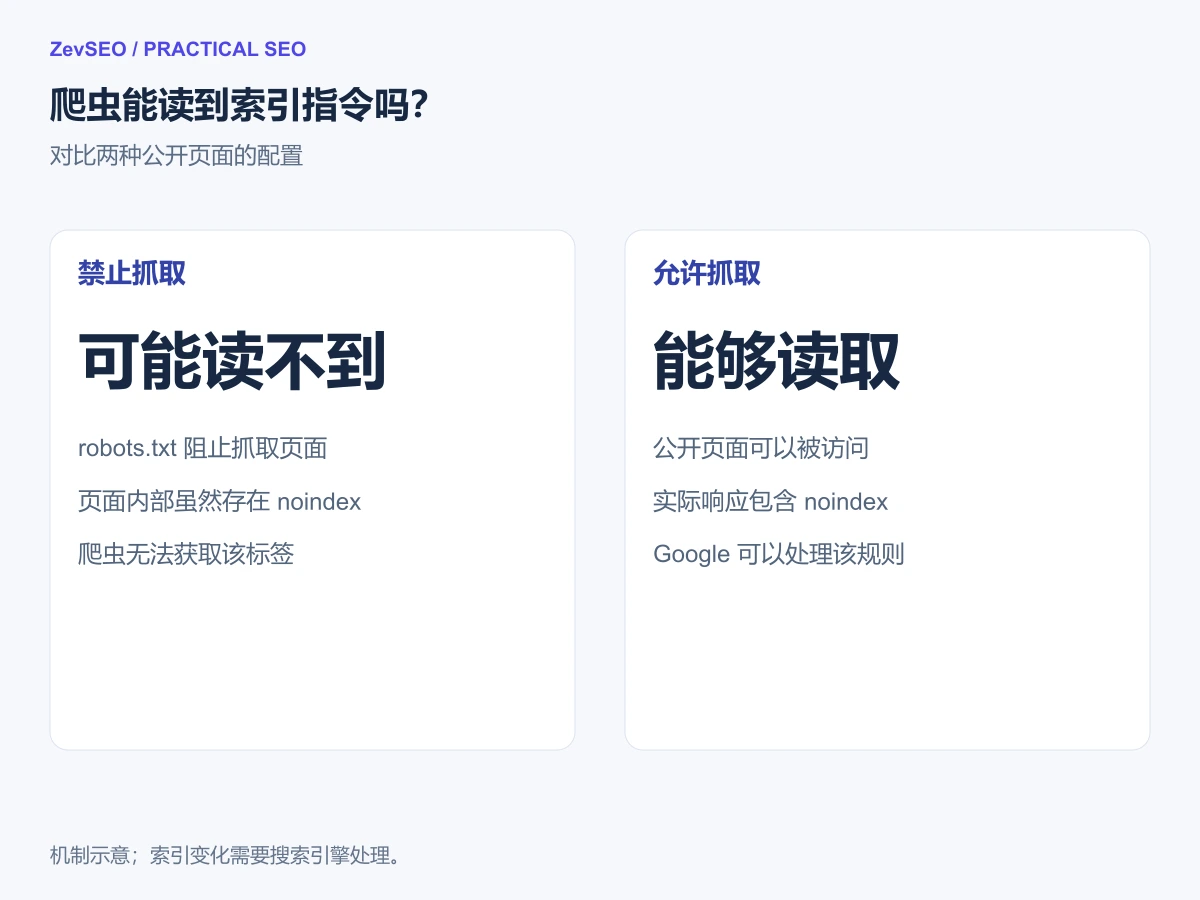
图 1:页面被禁止抓取时,其中的 noindex 可能无法被读取。此图为机制示意。
二、目标是管理抓取时,用 robots.txt
示例站点可以有这样一条简单规则:
User-agent: *
Disallow: /internal-search/
它要求遵守规则的爬虫避免抓取相应站点上的这段路径。它不能直接删除已收录 URL,也不能限制普通访客打开页面,更不能把内容变成私密内容。
文件应放在站点的 robots.txt 入口。核对实际主机名、协议和端口:生产站点的文件,不会自动控制另一个子域名。范围与匹配行为可查看 Google 的 robots.txt 规则说明。
初次核查时,先选一个爬虫、一条 URL 路径和对应规则。如果有多个 User-agent 分组、通配符或相互重叠的 Allow 与 Disallow,应按官方匹配规则核对,不要认为「文件里最先出现的一行一定生效」。
三、公开页面不该进入搜索时,用 noindex
假设一个公开的提交成功页需要供用户查看,但没有必要成为搜索入口。对于 HTML,可以在 head 中设置:
<!doctype html>
<html lang="zh-CN">
<head>
  <meta charset="utf-8">
  <meta name="robots" content="noindex">
  <title>已收到你的请求</title>
</head>
<body>
  <p>我们已收到你的请求。</p>
</body>
</html>
标题和文字是示例内容。只对目标页面或指定页面类型添加标签,避免误放进生产环境所有页面共用的布局。
如果是 PDF,或不适合添加 HTML 元标签的资源,可以在实际响应中使用:
HTTP/1.1 200 OK
Content-Type: application/pdf
X-Robots-Tag: noindex
这个标头必须出现在 HTTP 响应头里,写进 HTML 正文或 PDF 文本没有同样的作用。具体机制可参考 Google 的 robots 元标签与 X-Robots-Tag 说明。
无论采用哪种方法,都要核实爬虫能取得目标响应并读到指令。添加 noindex,不代表 Google 已有的索引记录会立即更新。
四、不要让抓取限制挡住自己的索引指令
假设 robots.txt 中写了:
User-agent: *
Disallow: /thank-you/
而 /thank-you/ 页面又包含 noindex。Googlebot 如果遵守抓取限制,就无法取得页面,也就读不到这个标签。
如果目标是让一个公开的提交成功页退出搜索,应让这个特定 URL 可以被抓取,再返回 noindex。同时检查更宽泛的目录规则与爬虫专属分组:删掉一行,不一定就消除了实际阻止。Google 在 noindex 实施指南中明确说明了可抓取要求。
如果页面包含私密信息,继续用访问控制保护它。不要为了让爬虫读取索引指令,就把私密内容公开。
| 示例配置 | 可能发生什么 | 下一步 |
|---|---|---|
| 允许抓取,noindex 可以读取 | Google 能够处理排除指令 | 核对响应,之后检查索引状态 |
| 禁止抓取,noindex 只在页面里 | 排除指令可能无法读取 | 对公开内容解决抓取冲突 |
| 禁止抓取,没有 noindex | 从其他地方发现的 URL 仍可能出现在搜索中 | 按真实目标选择机制 |
| 需要身份验证 | 匿名访问者不能读取受保护内容 | 保留访问保护,另行评估之前的公开曝光 |
也不要把 Noindex: 写进 robots.txt 就认为它能生效。Google 不支持这种写法,同一份 noindex 指南也对此作了说明。
五、先核对实际响应,再核对 Google 记录
配置部署后,应检查真正希望控制的 URL,包括经过跳转后到达的最终地址。
- 检查访问。 目标公开页面是否能打开,还是发生跳转、要求登录或返回错误?
- 查看对应 robots.txt。 找到目标爬虫分组与实际作用于该路径的规则。
- 检查响应。 同时查看 HTML head 和 HTTP 响应头。CMS、应用和代理都可能影响最终返回的索引指令。
- 使用 URL 检查。 对照当前访问情况、索引版本与最近记录的抓取信息。
- 等待处理后复核。 当前页面测试通过,不表示 Google 的索引已经更新。
Google 的 URL 检查工具说明区分了索引版本信息与实时测试。变更日志里也应该将两者分别记录。
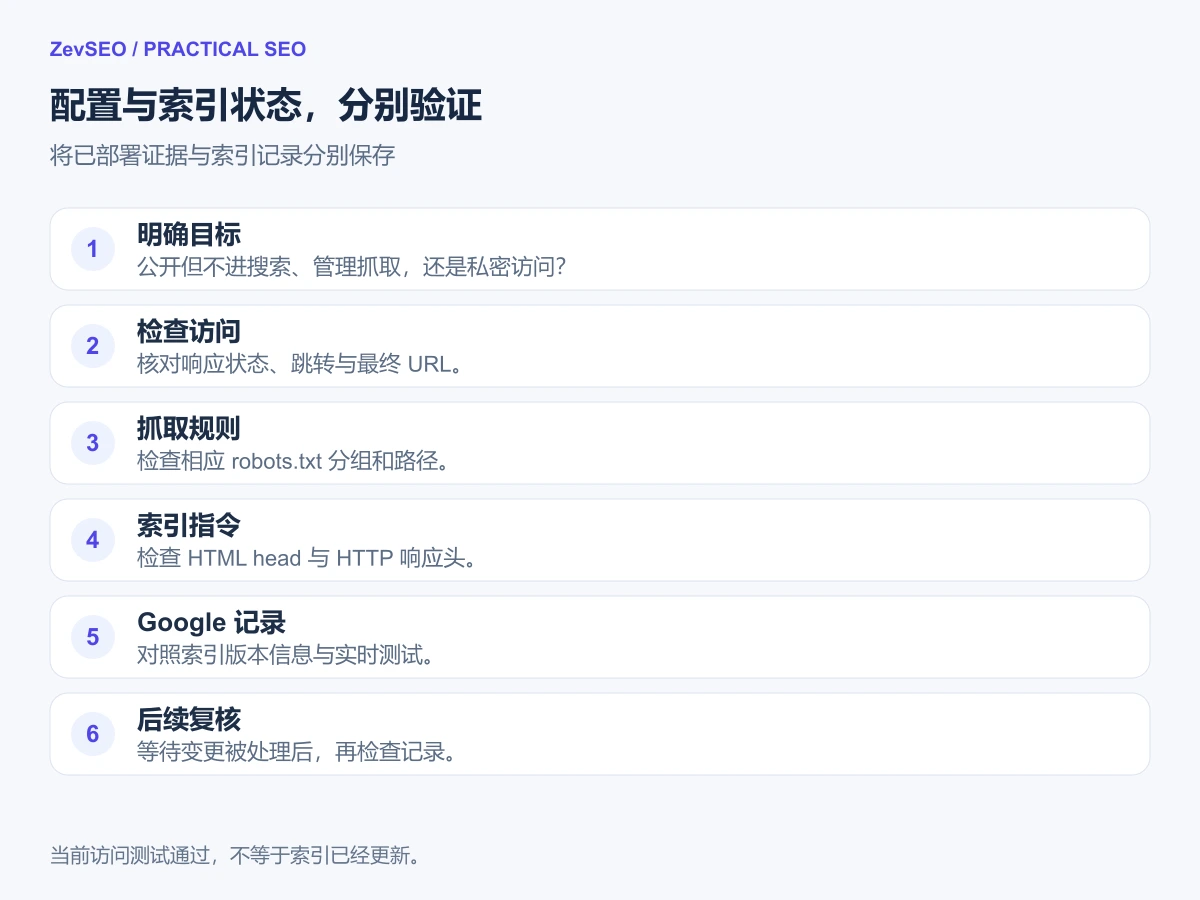
图 2:已部署配置与搜索引擎记录的状态,需要分别验证。
与开发人员沟通时,可以保存这张简表:
| 字段 | 记录什么 |
|---|---|
| URL 与目标 | 公开但排除搜索、管理抓取,还是私密访问 |
| 实际响应 | 时间、状态码、跳转与最终 URL |
| 爬虫访问 | 对应 robots.txt 分组和规则 |
| 索引指令 | 实际元标签或响应头 |
| Google 信息 | 分别记录索引版本发现与实时测试发现 |
六、按工具的实际能力使用检测结果
ZevSEO robots.txt 工具可以获取文件,帮助查看简单路径规则。先从一条不复杂的规则和相应爬虫开始。
当前检测器属于基础规则检查,不能完整复现 Google 对全部分组、通配符与优先级组合的处理。它也不会读取目标页的 noindex,更不能证明页面当前是否已收录。复杂情况应结合官方规则文档和 URL 检查工具核对。
这样就不会把一个绿色的「允许抓取」结果,直接当成「页面可以进入索引」。它们回答的是不同问题。
常见问题
Disallow 能让已经收录的页面退出索引吗?
不要依赖它完成删除。先决定资源应公开但不进搜索、需要访问保护,还是应该删除,再选择对应机制并核实结果。
noindex 一定要与 nofollow 一起使用吗?
两者表达不同指令。为了排除当前页面,本文只使用 noindex;不要在没有明确目标时顺手加上其他指令。
移除 noindex,页面就一定能获得排名吗?
不是。还要核对访问、抓取规则和页面内容。移除一道限制,不代表保证收录或获得某个排名。
测试站只用 robots.txt 保护,可以吗?
不可以。测试环境应使用身份验证或其他合适的访问限制。公开可读的 robots.txt 文件,无法保护列出路径中的内容。
先确定目标,再修改规则
公开页面需要退出搜索,就让对应索引指令能够被读取;需要管理抓取,就配置目标爬虫与路径的规则;涉及私密内容,就落实访问控制。
可以先用 ZevSEO 查看 robots.txt,再核对页面响应和 Google 记录,最后判断问题是否真正解决。